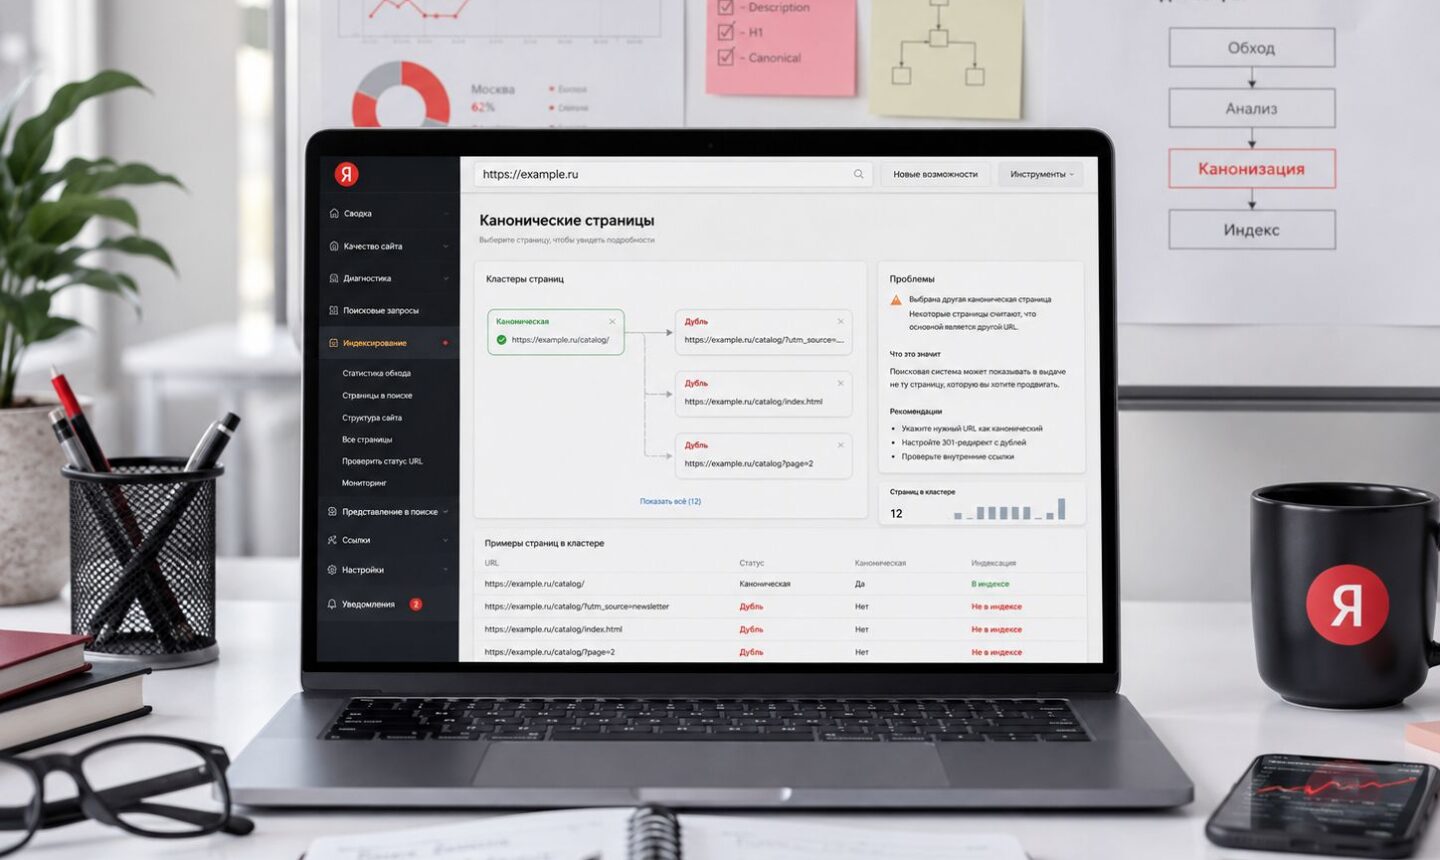
Если Яндекс выбрал другую каноническую страницу, нужный URL перестаёт участвовать в поиске как самостоятельный документ. Поисковик посчитал несколько страниц похожими или идентичными и выбрал одну — основную. В выдаче будет только она. Остальные, включая ту, которую вы продвигаете, уходят в статус дублей.
Именно здесь начинается главная боль: страница технически существует, открывается в браузере, на неё потрачено время и деньги — а показов нет. В Яндекс Вебмастере URL стоит с пометкой «Дубль», а в качестве основной указана совсем другая страница. Что это: технический дубль, который не нужно трогать? Ошибка rel canonical? Смысловая каннибализация? Последствие редизайна? И что делать — исправлять тег, настраивать редирект, переписывать страницу или всё сразу?
Эта статья — пошаговое практическое руководство именно для этого сценария. Он принципиально отличается от ситуации, когда страница не индексируется в Яндексе из-за технических запретов. Там проблема в доступности. Здесь — в том, что страница доступна, но Яндекс считает её вторичной по отношению к другому URL. Это тоже другой сценарий, чем страница в индексе, но нет показов: там страница участвует в поиске, просто не получает видимости. Здесь она вообще исключена как дубль.
Разберём по порядку: что происходит, где смотреть, почему это случилось и как возвращать нужную страницу в поиск. Если вы занимаетесь SEO-продвижением сайта и видите в Вебмастере массовые дубли — эта статья поможет выстроить системную работу, а не тратить время на точечные правки без понимания причины.
Что такое каноническая страница и как это работает
Зачем нужна каноническая страница
Современные сайты почти неизбежно порождают дубли. Один и тот же контент оказывается доступен по нескольким адресам: с параметрами и без, с www и без, через http и https, с сортировкой и без неё, в нескольких версиях пагинации. Для пользователя это незаметно. Для поискового робота — проблема: он видит несколько документов с одинаковым или очень похожим содержимым и должен решить, какой из них показывать в поиске.
Концепция канонической страницы решает именно эту задачу. Каноническая страница — это основная, «авторитетная» версия документа среди группы дублей или похожих URL. Поисковик индексирует её как главную, передаёт ей сигналы ранжирования и показывает в выдаче. Остальные URL из группы считаются вторичными: они могут существовать и быть доступны пользователям, но в поиске они не участвуют как самостоятельные страницы.
Для сайта это важно по нескольким причинам. Во-первых, без каноникализации поисковый вес размывается между дублями вместо того, чтобы концентрироваться на нужном URL. Во-вторых, робот тратит краулинговый бюджет на обход дублей вместо приоритетных страниц. В-третьих, в выдаче может оказаться не та страница — не та, которую вы продвигаете, а та, которую Яндекс посчитал более важной по своим алгоритмическим критериям.
Как Яндекс выбирает canonical — своя логика или подсказка сайта
Яндекс может выбирать каноническую страницу двумя способами: следовать подсказке сайта или принять самостоятельное решение.
Подсказка сайта — это тег rel="canonical" в HTML-коде. Когда страница содержит в секции <head> строку вида <link rel="canonical" href="https://example.ru/usluga/" />, она сообщает поисковику: «Считай основной версией вот этот адрес». Если тег указан правильно и Яндекс ему доверяет, он выбирает именно этот URL как канонический.
Но Яндекс не обязан следовать тегу безоговорочно. Если поисковик видит, что canonical указывает на страницу с явными признаками слабости — нет внутренних ссылок, нет в sitemap, отличается по содержанию от объявленного URL, или canonical сам на себя стоит на странице-дубле — алгоритм может проигнорировать тег и выбрать другой URL на основе собственных сигналов. Это происходит чаще, чем кажется, особенно если canonical проставлен формально, без понимания логики.
Собственный выбор Яндекса строится на совокупности сигналов: какая страница получает больше внутренних ссылок, какая чаще встречается в sitemap, какая быстрее отвечает, у какой более сильный Title и структура, какая страница более доступна и стабильна. Именно поэтому ситуация, когда Яндекс выбрал другой canonical вопреки тегу, — это не глюк системы, а сигнал: что-то в структуре сайта или сигналах противоречит указанному канонику.
Чем rel canonical отличается от 301-редиректа и noindex
Это три разных инструмента с разной логикой, и их нельзя применять взаимозаменяемо.
rel=»canonical» — это рекомендация. Страница-дубль остаётся доступной пользователю, но поисковику сообщается, что основная — другая. Робот может обходить дубль, но в поиске показывать будет каноническую версию. Инструмент подходит, когда дубль нужен пользователям (например, страница фильтра с отдельным URL, удобным для шаринга), но в поиске достаточно одной версии.
301-редирект — это постоянное перенаправление. Пользователь, перешедший по адресу дубля, автоматически попадает на основную страницу. Поисковик понимает, что старый адрес перестал существовать, и переносит все сигналы на новый. Это жёсткий инструмент: дубль исчезает полностью. Подходит, когда дубль не нужен ни пользователям, ни поиску.
noindex — запрет на включение страницы в индекс. Робот может обходить URL, но не добавляет его в поиск. Используется реже, обычно для технических страниц (личный кабинет, страницы корзины, страницы успешной оплаты), которые нужны пользователям, но не должны быть в выдаче.
Главная ошибка — ставить canonical там, где нужен редирект, или наоборот. Если дубль реально не нужен и никогда не будет нужен пользователю — делайте редирект. Если страница нужна пользователю, но не должна конкурировать в поиске — canonical. Если страница вообще не должна попадать в поиск — noindex. Эти инструменты не заменяют друг друга, и только правильный выбор даёт ожидаемый результат.
Где увидеть проблему в Яндекс Вебмастере
Статус «Дубль» в разделе исключённых страниц
Главное место диагностики — Яндекс Вебмастер, раздел «Индексирование» → «Страницы» → «Исключённые страницы». Здесь собраны все URL, которые Яндекс знает, но не включает в поиск. Среди статусов исключения нас интересует один: «Дубль» или формулировка в духе «Страница исключена как дубль другой страницы».
Если нужный URL попал в этот список — Яндекс уже принял решение: этот адрес вторичен. Он не участвует в поиске самостоятельно. Все показы, клики и трафик идут на другую страницу — ту, которую поисковик выбрал основной.
Важный нюанс: не каждый дубль в этом списке — проблема. Там могут быть UTM-ссылки, страницы сортировки, технические копии. Но если в список попала страница услуги, статья, категория интернет-магазина или региональная посадочная — это сигнал для немедленной диагностики.
Как найти выбранную Яндексом каноническую страницу
Нажмите на проблемный URL в списке исключённых страниц. Яндекс Вебмастер покажет детали: статус, дату последнего обхода, код ответа, наличие тега canonical в коде и — самое важное — какой URL выбран Яндексом как каноническая страница для этого дубля.
Именно этот адрес — ваша точка отсчёта. Теперь у вас есть два URL: тот, который должен быть основным (нужная страница), и тот, который Яндекс считает основным. Дальнейшая работа — это анализ причины расхождения и устранение конфликта.
Зафиксируйте оба адреса. Они понадобятся на каждом шаге диагностики.
Что смотреть по конкретному URL
По каждому проблемному URL в Вебмастере нужно проверить:
- Дата последнего обхода — как давно робот был на странице. Если давно, это дополнительный сигнал низкой приоритетности.
- Код ответа — страница должна отвечать 200. Если 301, 302 или другой код — это уже другая история.
- Canonical в коде — какой тег стоит в HTML страницы. Если он указывает на другой URL — здесь и есть причина дубля.
- Наличие в sitemap — если нужная страница отсутствует в карте сайта, это ослабляет сигнал её важности.
- Внутренние ссылки — сколько страниц сайта ссылаются на нужный URL. Если мало или вообще нет, Яндекс не видит страницу приоритетной.
Эти данные в совокупности дают полную картину: почему именно этот URL проиграл конкурентный отбор и стал дублем. Без такого анализа любые правки будут наугад. Такой подход — часть полноценной технической оптимизации сайта, без которой диагностика дублей не даёт системного результата.
Когда выбор другого canonical — это нормально
Прежде чем паниковать и бросаться исправлять canonical, нужно убедиться: это вообще проблема? Иногда Яндекс выбрал другой URL именно потому, что так и должно быть. Нужно понять разницу между ситуацией, которая требует вмешательства, и ситуацией, которую лучше не трогать.
Технические дубли, которые не нужно продвигать
Есть целый класс URL, которые порождаются автоматически и не несут самостоятельной SEO-ценности. Для них быть дублем — нормально и правильно. Поисковик выбрал основную версию страницы, а эти технические копии правомерно исключены.
Типичные примеры технических дублей:
- Страницы сортировки:
/catalog/?sort=price,/catalog/?sort=popular - Страницы с сессионными идентификаторами:
/usluga/?session=abc123 - Страницы с якорями:
/article/#section2 - Страницы поиска по сайту с запросами в URL
- Страницы с параметром
print=1илиversion=mobile - Страницы, автоматически созданные CMS при генерации черновиков или превью
- Старые URL страниц, которые переехали с 301-редиректом (если редирект настроен правильно)
Если Яндекс выбрал другой canonical для технического дубля и основной нужный URL при этом в поиске — всё в порядке. Вмешательство не нужно.
UTM-метки, параметры сортировки и сессионные ID
Отдельная и очень частая история — URL с UTM-метками. Когда ссылка на страницу распространяется в рекламе, email-рассылках или соцсетях с UTM-параметрами, каждый такой вариант технически является отдельным адресом:
text/usluga/
/usluga/?utm_source=email&utm_medium=newsletter&utm_campaign=may
/usluga/?utm_source=vk&utm_medium=social
Если на эти URL нет canonical на базовую страницу, Яндекс может выбрать любой из них как основной. Иногда в поиске оказывается страница с UTM-хвостом — она индексируется с параметрами в адресе, что выглядит некорректно и мешает продвижению.
В такой ситуации правильное решение простое: на всех вариантах с UTM должен стоять canonical на чистый URL без параметров. Или — если UTM-страницы не нужны никому, в том числе пользователям — настроить Clean-param в robots.txt, чтобы Яндекс игнорировал эти параметры при обходе.
Дубли http/https и www — когда уже всё склеено правильно
Ещё один класс «нормальных» дублей — варианты протокола и поддомена:
texthttp://example.ru/
https://example.ru/
http://www.example.ru/
https://www.example.ru/
Если на сайте всё настроено правильно — редирект с http на https, редирект с www на без www (или наоборот, главное — консистентность), canonical на основную версию — Яндекс склеит эти варианты корректно. В поиске будет одна версия, остальные правомерно станут дублями.
Если же этот редирект настроен неполно или некорректно, можно увидеть странную ситуацию: Яндекс выбирает http-версию как каноническую, хотя сайт давно переехал на https. Или выбирает www-вариант, хотя весь трафик идёт на non-www. Это уже нужно исправлять — через 301-редирект и canonical.
Когда это проблема — нужная страница стала дублем
Это настоящая проблема, когда дублем стала страница, которую вы целенаправленно продвигаете. Она несёт коммерческую ценность, под неё собрана семантика, написан текст, поставлены внутренние ссылки — а в поиске её нет, потому что Яндекс выбрал другой canonical.
Страница услуги стала дублем другой услуги
Это один из самых болезненных сценариев. На сайте есть несколько услуг, которые вы хотите продвигать по разным запросам. Но если описания похожи, Title близкие, H1 перекрываются, а структура одинаковая — Яндекс может посчитать их дублями и оставить в поиске только одну. Продвигаемая страница услуги при этом получает статус дубля.
Например, если у вас есть страницы «SEO-продвижение сайта» и «Продвижение сайта в поиске», и обе написаны по одному шаблону с незначительными вариациями, — это смысловые дубли. Яндекс выберет одну, вторая выпадет.
Статья склеилась с другой статьёй по тому же интенту
Это частая проблема у сайтов с обширным контентом. Публикуется несколько материалов по смежным темам — «как проверить сайт на SEO», «SEO-аудит сайта», «что проверить перед SEO-продвижением» — и если все они отвечают примерно на один вопрос, Яндекс выбирает сильнейшую и исключает остальные как дубли интента. Подробнее о том, почему страница, которая формально в индексе, не получает трафика, разобрано в материале про малоценную или маловостребованную страницу.
Категория интернет-магазина стала дублем другой категории
В интернет-магазинах продвижение категорий строится на уникальных посадочных страницах под разные группы товаров. Но если категории имеют одинаковый шаблон, похожее описание и одинаковую структуру листинга, Яндекс склеивает их. В поиске остаётся одна, остальные становятся дублями. Трафик на категорию теряется, SEO-продвижение интернет-магазина буксует.
Страница фильтра получила статус дубля
Страницы фильтров — отдельная история. В магазинах с развитой фасеткой каждая комбинация фильтров порождает отдельный URL. Большинство из них — технические дубли без поискового спроса. Но некоторые фильтры («красные платья», «ноутбуки до 50000 рублей», «диваны угловые с доставкой») имеют реальный спрос и должны участвовать в поиске как самостоятельные страницы. Если такой фильтр получает статус дубля категории — это потеря трафика.
Региональная страница стала дублем другой региональной
Компании, работающие в нескольких городах, часто создают региональные посадочные страницы. Если все они написаны по одному шаблону — тот же текст, то же описание услуги, только название города заменено — Яндекс неизбежно посчитает их дублями. В поиске по запросам конкретного города нужная региональная страница не покажется, потому что она стала дублем другой такой же. Как строить региональное присутствие без дублей — разобрано в материале про региональное SEO-продвижение сайта.
Почему Яндекс выбрал другую страницу — основные причины
Одинаковый или похожий контент
Это самая прямая причина. Яндекс оценивает текстовое содержимое страниц: если два документа совпадают полностью или содержат близкий по смыслу текст с минимальными отличиями, алгоритм признаёт их дублями. При этом оцениваются именно смысловые, а не словарные совпадения — частичная перефразировка не спасает от признания дублями.
Особенно уязвимы страницы, созданные по единому шаблону CMS: услуги, написанные одним автором в один день, региональные страницы с заменой топонима, описания категорий, скопированные с небольшими правками. Для поисковика всё это — одна страница в нескольких экземплярах.
Одинаковый Title и H1
Совпадение Title — один из самых чётких сигналов дублирования. Если две страницы имеют одинаковый или очень похожий Title, Яндекс получает прямую подсказку: эти документы об одном. Даже если тексты страниц немного отличаются, совпадение заголовков существенно повышает вероятность, что поисковик выберет одну из них основной.
То же касается H1. Совпадение основного заголовка усиливает сигнал схожести.
Ошибка rel canonical в коде страницы
Это технический сценарий, при котором сайт сам «просит» Яндекс сделать нужную страницу дублем. В коде страницы стоит тег canonical, который указывает на другой адрес. Яндекс следует этому указанию и выбирает тот URL, на который canonical ссылается.
Ошибка может быть:
- Шаблонной: CMS автоматически подставляет canonical на родительскую категорию, главную страницу или другой шаблонный адрес.
- Случайной: при копировании страницы в системе управления canonical не обновился и остался от исходного URL.
- Устаревшей: canonical указывает на старый адрес, существовавший до редизайна или переноса сайта.
- Неверно сконфигурированным SEO-плагином: плагин генерирует canonical по логике, которая не соответствует нужной структуре.
Дубли из-за GET-параметров
GET-параметры в URL — один из главных источников дублей на современных сайтах. Параметры сортировки, фильтрации, пагинации, отслеживания, цвета, размера, цены — каждый из них порождает технически отдельный адрес с тем же или очень похожим содержимым.
Пример для одной страницы каталога:
text/catalog/platya/
/catalog/platya/?sort=price_asc
/catalog/platya/?sort=popular
/catalog/platya/?page=2
/catalog/platya/?color=red
/catalog/platya/?color=red&sort=price_asc
Если эти URL индексируются без canonical на базовую версию, Яндекс обходит их все, пытается определить, какой главный, и нередко выбирает не тот, который вы ожидаете. Это прямая задача технической оптимизации сайта: закрыть ненужные параметры через canonical, Clean-param в robots.txt или noindex.
Внутренние ссылки ведут не на тот URL
Внутренняя перелинковка — один из ключевых сигналов, по которому Яндекс определяет, какая из схожих страниц важнее. Если большинство внутренних ссылок ведут на один адрес, а canonical указывает на другой — возникает конфликт. Поисковик может проигнорировать canonical и выбрать страницу, на которую чаще ссылается сам сайт.
Типичный сценарий: после редизайна или переноса структуры внутренние ссылки обновились и теперь ведут на новые URL, а canonical на старых страницах остался прежним. Яндекс видит: большинство ссылок указывают на новые адреса, canonical — на старые. Алгоритм выбирает новые, старые попадают в дубли.
Страница потеряла вес после редизайна или переноса сайта
Редизайн и перенос сайта — это высокорисковые события для индексации. Если в процессе что-то пошло не так: изменилась структура URL, не все редиректы настроены, canonical не обновлён, внутренние ссылки частично ведут на старые адреса — страницы начинают конкурировать сами с собой. Одни URL получают статус основных, другие — дублей. Подробно о том, как сохранить позиции в таких ситуациях, рассказано в материале про SEO при редизайне и переносе сайта.
Как проверить rel canonical в коде страницы
Где искать тег canonical в HTML
Тег canonical находится в секции <head> HTML-документа. Выглядит он так:
xml<link rel="canonical" href="https://example.ru/usluga-seo/" />
Чтобы проверить его на конкретной странице, откройте URL в браузере, нажмите правой кнопкой → «Просмотр кода страницы» и в разделе <head> найдите строку с rel="canonical". Это самый быстрый способ увидеть, что фактически видит поисковик.
Важно: смотрите именно финальный HTML, который отдаёт сервер, а не настройки в интерфейсе CMS. Это не всегда одно и то же. Некоторые плагины, кеширующие системы или серверные конфигурации могут менять canonical на лету, и в итоге в коде страницы будет не то, что показывает панель управления.
Для массовой проверки используйте инструменты типа Screaming Frog или аналогичные краулеры: они обходят весь сайт и показывают canonical для каждого URL в виде таблицы.
Типичные ошибки шаблонов CMS
Большинство ошибок canonical — это не ручные правки, а системные баги шаблонов. Вот самые распространённые:
1. Canonical на главную страницу для всех страниц. Встречается на сайтах, где тег canonical добавлен в общий шаблон header.php или аналогичный файл и прописан статически: href="https://example.ru/". В результате все страницы сайта указывают canonical на главную. Яндекс быстро понимает этот паттерн и перестаёт доверять тегу, но проблема остаётся.
2. Canonical на категорию со всех страниц раздела. Плагин или шаблон автоматически подставляет canonical на родительскую страницу. Каждая статья категории «Статьи о SEO» говорит поисковику: «Основная страница — это /blog/». Результат — все статьи исключены как дубли страницы блога.
3. Canonical скопирован вместе с контентом. При создании новой страницы через «копировать существующую» SEO-плагин не сбрасывает canonical. Новая страница хранит canonical от исходной.
4. Canonical не соответствует текущему URL из-за смены структуры. После редизайна URL поменялись, но canonical в базе данных CMS хранит старые адреса. Страница https://example.ru/novaya-stranica/ имеет canonical https://example.ru/stariy-url/, который уже отдаёт 404.
5. Canonical без протокола или без домена. Ошибка верстальщика: <link rel="canonical" href="/usluga/" /> вместо полного URL. Часть поисковиков дополняет его автоматически, но это ненадёжно.
Когда canonical правильный, но Яндекс всё равно выбрал другой
Это самая неочевидная ситуация. Canonical настроен корректно, но поисковик всё равно выбирает другой URL как основной. Почему?
Причин несколько. Первая — противоречие между canonical и другими сигналами. Если тег говорит «основная страница А», а все внутренние ссылки ведут на «страницу Б», Яндекс может доверять внутренней структуре больше, чем тегу. Решение: согласовать canonical и перелинковку.
Вторая причина — страница, указанная в canonical, слабее альтернативного URL. Нет в sitemap, нет внутренних ссылок, низкая скорость загрузки, бедный контент. Яндекс выбирает более «авторитетный» адрес, даже если canonical указывает на другой.
Третья причина — технические проблемы: canonical указывает на страницу, которая отдаёт редирект или ошибку. Поисковик видит, что назначенный канонический адрес недоступен, и ищет замену. Это частая ошибка после редизайна: canonical не обновлён после смены URL-структуры.
Дубли из-за GET-параметров — отдельная история
Какие параметры создают дубли
GET-параметры — это, пожалуй, самый массовый источник дублей на любом динамическом сайте. Они добавляются к URL после знака ? и меняют вид страницы без изменения её базового адреса. Вот какие параметры чаще всего создают дубли:
| Тип параметра | Примеры | Создаёт ли дубль |
|---|---|---|
| Сортировка | ?sort=price, ?order=asc | Да — контент идентичен, только порядок разный |
| Пагинация | ?page=2, ?p=3 | Частично — страница 2 может иметь ценность |
| Фильтры | ?color=red, ?size=xl | Зависит от спроса |
| UTM-метки | ?utm_source=email | Да — контент полностью идентичен |
| Сессии | ?session=abc, ?sid=123 | Да — технический параметр |
| Версия | ?ver=mobile, ?print=1 | Да |
| Язык/регион | ?lang=ru, ?region=77 | Зависит от структуры |
| Кеш-бастеры | ?v=20240101, ?t=1234567 | Да |
Ключевой вопрос при работе с каждым типом параметров: есть ли под этот вариант URL реальный поисковый спрос? Страница «красные платья» с отдельным URL и реальным спросом — это самостоятельная посадочная, которую стоит продвигать. Страница с параметром сортировки — технический дубль без спроса.
Как закрыть параметры без потери пользы для пользователя
Главный принцип: закрывать от индексации нужно только те параметры, которые не несут самостоятельной SEO-ценности. Перед закрытием всегда проверяйте, есть ли поисковый спрос по этой комбинации.
Для параметров без поискового спроса (UTM, сортировка, сессии) — canonical на базовую страницу без параметра, или директива Clean-param в robots.txt:
textClean-param: utm_source&utm_medium&utm_campaign&sort&order /catalog/
Для параметров с потенциальным спросом (фильтры, цвет, тип) — анализ частотности запросов, и на основе анализа: или полноценная страница с уникальным контентом, или canonical на категорию.
Для пагинации — canonical на первую страницу (если страницы пагинации не имеют самостоятельного спроса) или noindex (если хотите, чтобы робот обходил, но не индексировал).
Canonical, robots.txt или редирект — что выбрать
Это практический вопрос без универсального ответа. Логика выбора инструмента:
- Canonical — когда URL нужен пользователю (или может понадобиться), но в поиске должна участвовать одна базовая версия. Пользователь перешёл по UTM-ссылке и видит правильную страницу, но в индексе только чистый адрес.
- Clean-param — когда параметры технические и автоматически генерируются CMS, не влияют на содержимое страницы (сессии, CMS-трекинг). Директива говорит роботу: «Игнорируй эти параметры, они не меняют контент».
- Редирект 301 — когда старый URL с параметром больше не нужен ни пользователю, ни поиску. Жёсткое и чистое решение.
- noindex — когда URL нужен пользователю в интерфейсе сайта, но не должен попадать в поиск. Например, результаты поиска по сайту или страница сравнения товаров.
Дубли региональных страниц
Почему шаблонный текст = дубль для Яндекса
Региональные страницы — это один из самых частых источников массовых дублей на корпоративных сайтах. Компания работает в 10 городах и создаёт 10 страниц вида «SEO-продвижение в [Город]». Если все они написаны по единому шаблону — один и тот же текст с заменой названия города, одинаковый список услуг, одинаковые блоки преимуществ, одинаковый FAQ — Яндекс посчитает их дублями.
Это работает жёстко: Яндекс оценивает текстовую близость и смысловое совпадение. Простая замена «Москва» → «Санкт-Петербург» не создаёт уникальной страницы с точки зрения поисковика. В результате в поиске остаётся одна-две страницы, остальные исключаются. При этом часто в поиске оказывается не самая важная региональная страница, а та, у которой случайно оказался самый сильный набор косвенных сигналов.
Про системный подход к региональному присутствию без дублей — в отдельном материале про региональное SEO-продвижение сайта.
Что добавить, чтобы региональная страница стала самостоятельной
Региональная страница должна давать пользователю то, чего нет на аналогичных страницах других городов. Конкретно:
- Реальный адрес и контакты офиса в конкретном городе: улица, телефон, ближайшее метро или ориентир.
- Локальные кейсы и примеры работ: «Мы продвигали сайт компании X из Екатеринбурга — вот результаты».
- Региональные условия: доставка в конкретный город, сроки, стоимость, особенности логистики.
- Отзывы клиентов из этого города с датами и названиями компаний.
- Локальный FAQ: «Как долго едет курьер из Москвы в Казань?», «Есть ли самовывоз в Нижнем Новгороде?»
- Описание местной специфики: если рынок города действительно отличается, это стоит отразить.
- Уникальный текстовый блок про работу в регионе — не шаблонный, а реально написанный с учётом местной аудитории.
Если добавить это нечего — лучше иметь одну сильную страницу с охватом нескольких регионов, чем десять слабых дублей.
Как выбрать правильную каноническую страницу
Критерии выбора основного URL
Когда перед вами стоит выбор между двумя или несколькими URL — какой сделать основным — нужно руководствоваться чёткими критериями, а не интуицией.
1. Интент и полнота ответа. Основной должна быть страница, которая лучше всего отвечает на вопрос пользователя. Если одна версия раскрывает тему полнее, имеет структуру, FAQ, практические блоки — она кандидат на основную.
2. Коммерческая важность. Если одна страница — это посадочная с формой заявки, описанием услуги и ценами, а другая — техническая копия без этих блоков, очевидно, что основной должна быть коммерческая.
3. Внутренние ссылки. Проверьте, на какой из URL ссылается большинство страниц сайта. Это один из главных сигналов важности для поисковика.
4. Наличие в sitemap. Если один URL есть в карте сайта, а другого нет — первый приоритетнее.
5. История индексации. Если один URL давно в поиске и имеет историю показов, а другой новый — лучше сохранить историю и сделать основным старый URL (при условии, что он технически корректен).
6. Стабильность и доступность. Основной URL должен отвечать 200, загружаться быстро, быть доступен без редиректов.
7. Корректность адреса. Предпочтителен «чистый» URL без параметров, UTM, сессионных хвостов и технических суффиксов.
Что нельзя делать при выборе canonical
Несколько запретов, которые нарушают чаще всего:
- Не ставьте canonical на главную страницу сайта для всех страниц. Это системная ошибка, которая превращает весь сайт в дубль главной.
- Не выбирайте canonical случайно, без анализа интента и сигналов. Неправильный выбор приведёт к тому, что Яндекс проигнорирует тег.
- Не делайте canonical на страницу с редиректом или ошибкой 404. Поисковик обнаружит нерабочий canonical и перестанет доверять тегу.
- Не оставляйте дубли без canonical вообще, надеясь, что Яндекс сам разберётся. Иногда разбирается, но не так, как нужно вам.
- Не создавайте цепочки canonical: страница А → canonical на Б → canonical на В. Это путаница. Canonical должен вести напрямую на основной URL.
Что делать — пошаговый план возврата нужной страницы в поиск
Шаг 1. Проверить Вебмастер и найти выбранный canonical
Зайдите в Яндекс Вебмастер → «Индексирование» → «Страницы» → «Исключённые». Найдите нужный URL, откройте его карточку. Зафиксируйте:
- Статус исключения (должно быть «Дубль»)
- URL, который Яндекс выбрал как каноническую страницу
- Дату последнего обхода
- Код ответа страницы
Если URL вообще не отображается в Вебмастере — возможно, речь о проблеме индексации, а не дублей. В таком случае нужен другой разбор.
Шаг 2. Проверить rel canonical в коде обеих страниц
Откройте исходный HTML нужной страницы (View source) и найдите строку с rel="canonical". Запишите, куда она ведёт. Затем откройте HTML страницы, которую Яндекс выбрал канонической, и посмотрите её canonical.
Возможные варианты:
- На нужной странице canonical ведёт на другой URL → ошибка canonical, нужно исправить.
- На нужной странице canonical ведёт на саму себя → технически верно, ищем другую причину.
- Canonical отсутствует → страница без самоканоникализации, что само по себе риск.
- Canonical ведёт на страницу с редиректом или 404 → битый canonical.
Шаг 3. Сравнить страницы по содержанию и интенту
Откройте обе страницы рядом: нужную и ту, которую Яндекс выбрал основной. Сравните:
- Title и H1: насколько они совпадают?
- Структуру H2: одинаковые разделы или разные?
- Текст: процент совпадения смысла?
- Интент: оба документа отвечают на один и тот же вопрос пользователя?
- Объём и глубину: какая страница полнее?
Если страницы по сути об одном — это смысловой дубль. Технический фикс canonical здесь не поможет. Нужна работа с содержанием.
Шаг 4. Выбрать стратегию — canonical, 301 или переработка
На основе анализа из шагов 1–3 выберите стратегию:
| Ситуация | Стратегия |
|---|---|
| Ошибка canonical: тег указывает не туда | Исправить canonical в коде |
| Технический дубль с параметрами | Canonical + Clean-param в robots.txt |
| Дубль из-за внутренних ссылок на другой URL | Исправить перелинковку + canonical |
| Смысловые дубли: страницы об одном | Объединить + 301-редирект |
| Разные интенты, но похожий контент | Переработать одну или обе страницы |
| Региональный дубль | Добавить уникальный региональный контент |
| Дубль после редизайна | Настроить редиректы + обновить canonical |
Шаг 5. Исправить ошибки и обновить sitemap
После выбора стратегии:
- Исправьте canonical в коде страницы (или в настройках SEO-плагина).
- Если нужен редирект — настройте 301 с дубля на основной URL.
- Уберите дубли из sitemap.xml — в карте сайта должны быть только основные URL.
- Добавьте нужную страницу в sitemap, если её там не было.
- Проверьте robots.txt: нет ли там запретов, случайно затрагивающих нужный URL.
Это часть работы по внутренней оптимизации сайта: canonical, sitemap и robots.txt должны давать согласованные сигналы, а не противоречить друг другу.
Шаг 6. Поправить внутренние ссылки
Проверьте: все ли внутренние ссылки на нужную страницу ведут на правильный URL? Если часть ссылок после редизайна или другого вмешательства ведёт на альтернативный адрес — это конфликт сигналов. Яндекс будет выбирать тот URL, на который ссылаются чаще.
Исправьте ссылки в:
- главном меню и подменю
- футере
- хлебных крошках
- блоках «Смотрите также» и «Похожие материалы»
- текстах статей, которые упоминают нужную страницу
- карте сайта в формате HTML (если она есть)
Чем больше внутренних ссылок правильно ведут на нужный URL, тем сильнее сигнал его приоритетности.
Шаг 7. Запросить переобход и проверить результат
После всех исправлений — запросите переобход нужной страницы через Яндекс Вебмастер: «Инструменты» → «Переобход страниц». Это ускорит повторную проверку робота и позволит Яндексу увидеть изменения быстрее.
Ждите результат от 2 недель до 2 месяцев в зависимости от частоты обхода сайта и сложности изменений. Следите за статусом URL в Вебмастере: пока он числится дублем — процесс ещё не завершён. Когда статус изменится на «В поиске» — значит, нужная страница вернулась в индекс как самостоятельный документ.
Таблица диагностики — симптомы, причины, действия
| Симптом | Вероятная причина | Что делать |
|---|---|---|
| URL помечен как «Дубль», canonical — другая страница | Ошибка rel canonical в коде | Исправить тег canonical, проверить шаблон CMS |
| Страница услуги стала дублем похожей услуги | Одинаковый контент, Title и H1 | Развести интенты, переписать тексты |
| Категория магазина стала дублем другой категории | Шаблонные описания без уникальности | Добавить уникальный текстовый блок, FAQ |
| Фильтр стал дублем категории | Нет уникальной SEO-ценности | Canonical на категорию или уникальный контент |
| Региональная страница стала дублем другой региональной | Шаблонный текст с заменой города | Добавить реальные локальные данные |
| Дубли с параметрами URL | GET-параметры без canonical | Canonical + Clean-param в robots.txt |
| Canonical правильный, но Яндекс выбрал другой URL | Противоречие между canonical и перелинковкой | Согласовать внутренние ссылки с canonical |
| Трафик идёт не на тот URL | Внутренние ссылки ведут на дубль | Исправить перелинковку на нужный URL |
| Статья стала дублем другой статьи | Повтор интента | Объединить материалы или развести интенты |
| После редизайна нужные страницы стали дублями | Старые canonical + неполные редиректы | Настроить 301-редиректы, обновить canonical |
| Canonical указывает на страницу с 404 | Битый canonical | Исправить canonical на рабочий URL |
| Много дублей в разных разделах | Системная ошибка шаблона CMS | Технический аудит canonical-генерации |
Типичные ошибки при работе с canonical
Работа с каноническими страницами кажется технически простой: нашёл тег, изменил URL, сохранил. Но именно из-за этой кажущейся простоты в этой зоне живёт больше всего хронических ошибок. Вот что делают неправильно чаще всего.
Ставят canonical на главную страницу сайта для всех URL. Это системная ошибка, которая фактически говорит Яндексу: «Весь мой сайт — это дубль главной страницы». Поисковик быстро понимает паттерн, перестаёт доверять тегу, но урон уже нанесён.
Исправляют canonical без проверки внутренних ссылок. Тег поправили, а ссылки внутри сайта по-прежнему ведут на другой URL. Яндекс получает противоречивые сигналы и продолжает выбирать «свой» canonical.
Создают новые похожие страницы, не думая об интенте. Контент-план реализуется быстро, страниц становится много, но их темы пересекаются. Со временем Яндекс начинает их склеивать, и добавление каждой новой страницы создаёт новый дубль.
Закрывают важные страницы в robots.txt «на всякий случай». В попытке избавиться от дублей через robots.txt случайно закрывают нужные URL. Страница перестаёт обходиться, теряет сигналы, выпадает из поиска.
Используют временный редирект 302 вместо постоянного 301. Редирект настроен, но выбран неверный тип. Яндекс не переносит сигналы с дубля на основной URL, потому что 302 означает «временно», а не «навсегда».
Оставляют дубли в sitemap.xml. После настройки canonical или редиректов дубли не убираются из карты сайта. Яндекс видит их в sitemap, считает это сигналом важности и начинает снова рассматривать как кандидатов на индексирование.
Ждут результата на следующий день. После исправления canonical владелец сайта заходит в Вебмастер через сутки и расстраивается: «Всё ещё дубль». Изменения в индексировании занимают от нескольких дней до нескольких недель, иногда дольше. Нужно подождать и затем проверять динамику.
Игнорируют каннибализацию, ограничиваясь техническим фиксом. Canonical исправлен, редиректы настроены, а страница всё равно остаётся дублем. Причина в том, что две страницы по-прежнему закрывают один интент. Тег canonical не решает смысловой проблемы — для этого нужна работа с содержанием.
Как это влияет на заявки и трафик
Ошибка canonical кажется технической мелочью, пока не посчитать реальные потери. Если нужная страница услуги стала дублем другой — она не получает показов. Нет показов — нет кликов. Нет кликов — нет трафика на посадочную. Нет трафика — нет заявок. Цепочка прямая.
Особенно критично это для коммерческих сайтов, у которых каждая страница услуги — это отдельная точка входа в воронку. Если продвигаете «SEO для интернет-магазинов» и «SEO для производственных компаний» как разные услуги с разными запросами и разными аудиториями, — и обе стали дублями из-за похожего шаблона — потери трафика удваиваются. Яндекс оставил в поиске одну, вторую исключил, и вы получаете ровно половину потенциальных клиентов.
То же самое работает для информационного трафика. Если статья-лидер, которая должна привлекать аудиторию и вести её на услуги, стала дублем другого материала — весь информационный поток идёт в никуда или к конкуренту. Связь между SEO-трафиком и заявками рвётся именно здесь: не на уровне контекстной рекламы или коммерческого предложения, а на уровне базовой видимости в поиске.
Это особенно болезненно для сайтов, которые перешли на SEO-продвижение сайта как основной канал привлечения клиентов. Если ключевые страницы — услуги, категории, посадочные — исключены из поиска как дубли, отдача от SEO будет несравнимо ниже потенциальной. И это не вопрос времени — это вопрос системной ошибки, которую нужно найти и устранить.
Ещё один аспект: краулинговый бюджет. Если Яндекс обходит десятки или сотни дублей вместо приоритетных страниц, он тратит ресурс на бесполезные URL. В результате важные новые страницы — новые услуги, новые статьи, обновлённые посадочные — индексируются медленнее или не индексируются вообще. Это замедляет весь процесс настройки SEO-продвижения сайта.
Когда нужен SEO-аудит
Самостоятельная диагностика работает, когда проблема точечная: один-два URL с неверным canonical, очевидная ошибка в шаблоне, единичный смысловой дубль. В таких случаях чек-лист из этой статьи и несколько часов работы достаточно.
Но есть ситуации, когда точечный подход не спасает:
- В Вебмастере десятки или сотни URL со статусом «Дубль», и непонятно, где корень проблемы.
- Дубли появляются системно в нескольких разделах сайта одновременно.
- Вы исправили canonical, но через несколько недель ничего не изменилось.
- Интернет-магазин с большим каталогом, фасеткой и параметрами — нужно понять, какие URL закрывать, а какие продвигать.
- После редизайна или смены CMS резко упал трафик, и нужно понять, какие страницы потеряли статус основных.
- Региональные страницы массово склеились, и неясно, какие из них восстанавливать, а какие объединять.
- Сайт работает давно, накопил историю правок и технических решений, которые противоречат друг другу — canonical тянет в одну сторону, редиректы в другую, внутренние ссылки в третью.
В таких случаях нужен системный технический аудит сайта: полный обход структуры краулером, анализ всех canonical по разделам, сравнение сигналов перелинковки, выявление конфликтов, приоритизация исправлений. Без этого можно бесконечно чинить один URL, пока рядом падают другие.
Хороший аудит даёт не список «что плохо», а конкретный план: какие страницы делаем основными, какие закрываем редиректом, какие переписываем, какие убираем из sitemap, какие требуют уникального контента. Это уже уровень SEO-продвижения сайта как системной работы, а не разовых точечных правок.
FAQ
Почему Яндекс игнорирует rel canonical и выбирает другой URL?
Яндекс следует тегу canonical, но не обязан делать это безоговорочно. Если поисковик видит, что страница, указанная в canonical, слабее альтернативного адреса — меньше внутренних ссылок, нет в sitemap, медленнее загружается, отдаёт редирект — он может выбрать более «авторитетный» URL самостоятельно. Чтобы Яндекс доверял тегу, нужно согласовать canonical с перелинковкой, sitemap и доступностью страницы.
Что делать, если Яндекс выбрал как канонический URL с UTM-параметрами?
Значит, на страницах с UTM нет canonical на чистый адрес, и Яндекс выбрал один из UTM-вариантов как основной. Решение: добавить canonical на все UTM-страницы, указывающий на базовый URL без параметров. Также рекомендуется настроить директиву Clean-param в robots.txt для полного исключения таких параметров из обхода.
Как быстро Яндекс переиндексирует страницу после исправления canonical?
Зависит от частоты обхода сайта. На активно обходимых сайтах изменения могут отразиться через 1–2 недели. На сайтах с редким обходом — от месяца до нескольких месяцев. Ускорить процесс помогает запрос переобхода через Яндекс Вебмастер и добавление нужного URL в sitemap.
Может ли 301-редирект создать дубли?
Сам по себе — нет. Но если редирект настроен как 302 (временный), Яндекс не переносит сигналы на целевую страницу и может продолжать воспринимать оба адреса как отдельные. Также дубли создаются, если 301-редирект настроен не на всех вариантах URL: например, http редиректит, но https — нет.
Нужно ли удалять дубли из sitemap.xml?
Да. Sitemap.xml должен содержать только те URL, которые вы хотите видеть в поиске как основные. Если дубль попал в карту сайта, Яндекс воспринимает это как сигнал его важности и снова рассматривает как кандидата на индексирование. Это создаёт постоянный конфликт с canonical.
Если страница стала дублем, теряет ли она весь накопленный вес?
Не мгновенно. Но со временем дубль перестаёт получать сигналы ранжирования. Все сигналы концентрируются на основной странице. Именно поэтому важно делать основным тот URL, который был в поиске дольше и имеет историю: при правильно настроенном canonical и редиректах вес переходит к нужному адресу, а не теряется.
Может ли дубль навредить всему сайту, а не только одной странице?
Да, особенно при массовых дублях. Большое количество дублей увеличивает нагрузку на краулинговый бюджет: робот тратит ресурсы на обход копий вместо важных страниц. Это замедляет индексацию новых материалов и может негативно сказаться на видимости сайта в целом.
Что лучше — canonical или редирект 301?
Зависит от задачи. Canonical используют, когда дубль нужен пользователям, но не должен самостоятельно участвовать в поиске. Редирект 301 — когда дубль не нужен совсем: пользователь должен попадать сразу на основной URL. Если страница не несёт никакой ценности для пользователя и не будет нести — делайте редирект. Это чище и однозначнее, чем canonical.
Как работает SITE PRO с дублями и каноническими страницами
Когда задача доходит до нас, диагностика начинается не с отдельного URL, а с полного обхода сайта. Краулер собирает все canonical, статусы ответов, данные перелинковки, наличие в sitemap — и строит карту конфликтов. Видно сразу: где canonical противоречит ссылкам, где дубли накопились шаблонно, где смысловая каннибализация, а где технические параметры порождают сотни лишних URL.
После этого для каждого проблемного кластера определяется стратегия: что делаем основным, что закрываем редиректом, что убираем из sitemap, что переписываем. Приоритеты расставляются по коммерческой важности страниц: сначала восстанавливаем в поиске ключевые посадочные и услуги, потом разбираемся с технической базой.
Если проблема затрагивает не только дубли, но и общую структуру сайта, логику категорий, региональное присутствие или архитектуру интернет-магазина — это уже выходит за рамки разовой правки и становится частью системной работы по SEO-продвижению сайта. Именно в таком формате исправление дублей даёт реальный эффект на трафик и заявки, а не просто улучшает статистику в Вебмастере.